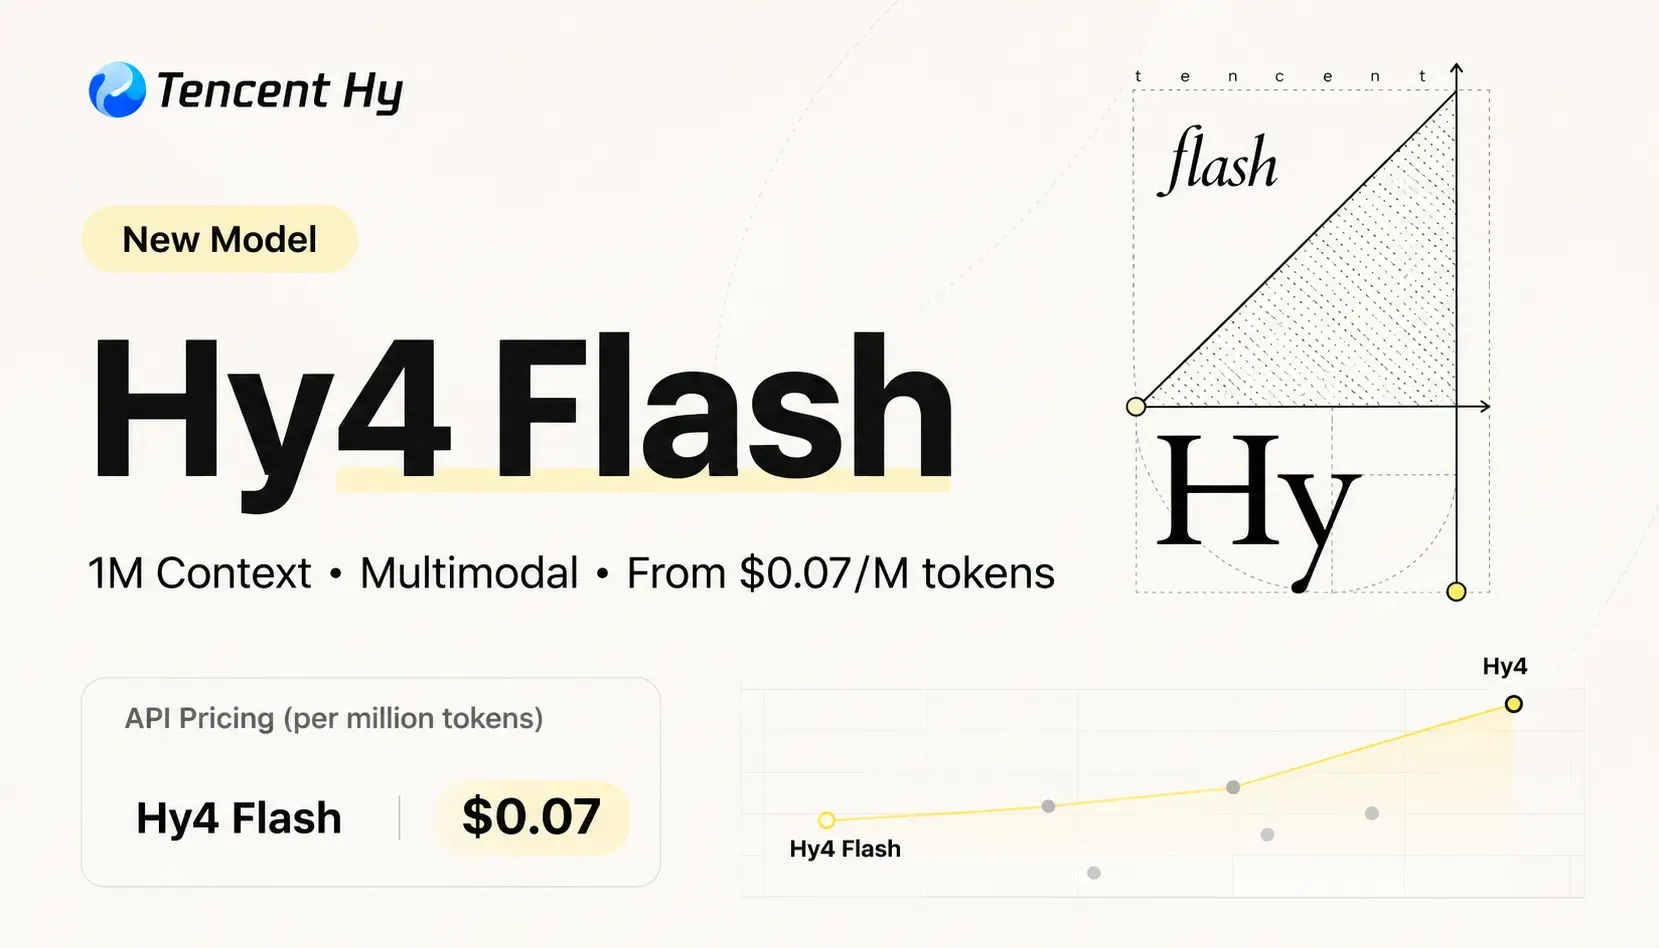
Hy4 flash da Tencent foi concebido para competir em custo-benefício, não para liderar exclusivamente em capacidade. O modelo combina 224 bilhões de parâmetros no total, mas usa apenas 12 bilhões de parâmetros ativos durante a inferência. Essa abordagem busca reduzir os custos de execução sem abrir mão de uma ampla capacidade armazenada. A Tencent destaca as entradas multimodais e uma janela de contexto de 1.000.000 de tokens, além de anunciar velocidades de decodificação acima de 150 tokens por segundo, graças a uma série de otimizações de inferência. Para equipes que avaliam qual modelo escolher, o Hy4 flash promete um meio-termo pragmático: bastante memória contextual e compreensão visual por uma fração do custo por tarefa de algumas alternativas de fronteira.
Por trás do modelo estão recursos arquitetônicos introduzidos ao longo da linha Hy: a parametrização Engram, que armazena conhecimento de longo prazo de forma compacta; a capacidade condicional LatentMoE, que concentra o processamento onde ele é necessário; e a atenção híbrida, que permite ampliar o contexto com eficiência. A Tencent também relata uma redução expressiva na memória ocupada pelo cache KV — uma decisão de engenharia deliberada para diminuir os custos de memória e de E/S do cache durante a inferência. Segundo a empresa, o aprendizado por reforço pós-treinamento reduziu pela metade o comprimento médio das respostas em tokens em tarefas típicas, diminuindo diretamente a cobrança por tokens de saída e acelerando muitos fluxos de trabalho profissionais.
A janela de contexto anunciada de 1 milhão de tokens e a velocidade de decodificação superior a 150 tokens por segundo são os recursos mais relevantes para operações empresariais. A Tencent atribui esses resultados à combinação de várias técnicas: otimização de megakernels, quantização de 4 bits, estratégias de execução DFly e um cache KV compacto. Na prática, contexto longo e decodificação rápida permitem processar documentos inteiros, apresentações ou conversas com vários arquivos em uma única passagem — materiais que, de outro modo, exigiriam divisão em trechos, recomposição de contexto ou orquestração de agentes, tudo com custos adicionais. Esses benefícios podem reduzir a complexidade de engenharia e a latência em fluxos de trabalho reais, desde que o desempenho do modelo com contexto longo se mostre robusto na prática.
Em termos econômicos, a Tencent informa preços aproximados de US$ 0,070 por milhão de tokens de entrada e US$ 0,281 por milhão de tokens de saída, além de uma tarifa ultrabaixa para entradas em cache. A empresa afirma que, em seu benchmark interno WorkIndex, o Hy4 flash tem um custo por tarefa muito menor que o de variantes maiores do Hy4 e de outros modelos de fronteira. Essa perspectiva é útil: para organizações que priorizam volume de processamento, previsibilidade de custos e fluxos de trabalho com documentos, o Hy4 flash pode reduzir significativamente as despesas operacionais. Ainda assim, os compradores devem considerar os benchmarks internos da Tencent e os resultados de avaliações cegas como referências, não como resultados verificados de forma independente; os custos e a qualidade comparativos precisam ser validados com tarefas representativas e de terceiros.